Auto-résolution des tickets par IA : le guide de déploiement
Auto-résolution des tickets par IA : le guide de déploiement
L’IA résout aujourd’hui, seule et sans intervention humaine, la majorité des tickets L1 à structure claire : statut de commande, réinitialisation de mot de passe, questions répétitives déjà documentées. La condition n’est pas le modèle utilisé mais la préparation : une base de connaissances propre, des connecteurs vers le ticketing et le CRM, et des tests sur l’historique réel. La méthode qui fonctionne suit un ordre précis : simuler, passer en mode copilote, puis activer l’autonomie catégorie par catégorie grâce à l’expertise d’une agence partenaire spécialisée en automatisation IA.
En bref:
- L’automatisation des tickets L1 repose principalement sur une préparation rigoureuse, notamment une base de connaissances actualisée et des connecteurs efficaces.
- La fiabilité de l’auto-résolution dépend d’une étape de simulation préalable sur l’historique réel, suivie d’une phase de copilote pour la validation humaine progressive.
- Il est conseillé de commencer par automatiser les tickets à fort volume, faibles risques et accès facile aux données, tels que les questions FAQ ou réinitialisations de mot de passe.
- La traçabilité et la sécurité des données exigent un contrôle strict des sources, la limitation d’accès aux données nécessaires, et une journalisation systématique de chaque décision automatisée.
- La réussite durable d’un projet d’auto-résolution nécessite une phase de montée en fiabilité avec seuils de confiance ajustables et audit régulier, plutôt qu’une mise en production immédiate et totale.
Table des matières
- Comment fonctionne le pipeline d’une auto-résolution tickets ia ?
- Comment choisir les tickets à automatiser en premier ?
- Quelles intégrations rendent l’IA fiable et traçable ?
- Comment déployer l’auto-résolution sans risquer le service client ?
- Quels indicateurs prouvent que l’auto-résolution fonctionne vraiment ?
- Comment sécuriser les données dans un système d’auto-résolution ?
- Comment gérer les tickets ambigus que l’IA ne peut pas résoudre seule ?
- L’auto-résolution IA respecte-t-elle la vie privée des clients ?
- Dans quels secteurs l’auto-résolution ia fait-elle déjà ses preuves ?
- Quel impact l’automatisation a-t-elle sur les équipes support ?
- Où l’IA échoue-t-elle encore sur les tickets complexes ?
- Perspective BotiqueAI
- Comment Botiqueai vous accompagne dans votre projet d’auto-résolution
- Sources
- Questions fréquentes
Comment fonctionne le pipeline d’une auto-résolution tickets ia ?
Un ticket qui arrive dans la file ne déclenche pas directement une réponse. Il traverse une chaîne de traitement où chaque étape conditionne la fiabilité de la suivante, et c’est là que se joue la différence entre un système qui rassure et un système qui multiplie les erreurs.
Le ticket est d’abord capturé et normalisé : texte, pièces jointes, métadonnées (canal, produit concerné, historique client) sont extraits dans un format exploitable. Vient ensuite l’enrichissement du contexte, où la technique de RAG (génération augmentée par récupération) prend tout son sens : le système va chercher dans le centre d’aide, les runbooks internes, les tickets similaires déjà résolus et les fiches CRM ou RMM pour construire une réponse ancrée dans des sources réelles plutôt qu’inventée par le modèle. Cette étape réduit fortement le risque de fabrication de réponses, un point que confirment plusieurs retours d’expérience sur les agents conversationnels de support.
Le système passe alors à la compréhension proprement dite : classification de l’intention, extraction des entités utiles (numéro de commande, référence produit, date), détection du ton du message. C’est sur cette base qu’intervient le calcul de confiance, qui détermine l’action suivante.
Quatre issues sont possibles à ce stade :
- Un brouillon de réponse est envoyé à un agent humain pour validation avant envoi.
- Une action prédéfinie s’exécute automatiquement (mise à jour de statut, envoi d’un lien, déclenchement d’un script RMM).
- Le ticket est clôturé directement, avec la réponse citant ses sources.
- Le dossier est escaladé vers un agent, accompagné d’un résumé du contexte déjà traité.
Zendesk illustre bien cette logique avec son assistance automatique, qui propose des suggestions de réponses, des macros et des actions, certaines pré-approuvées s’exécutant sans validation, les autres nécessitant l’accord d’un agent avant envoi.
Comment choisir les tickets à automatiser en premier ?
Toutes les catégories de tickets ne se prêtent pas également à l’automatisation. Trois critères permettent de trier rapidement les candidats sérieux des faux espoirs.
- Le volume et la simplicité du jugement requis. Les tickets « où est ma commande », les réinitialisations de mot de passe et les questions récurrentes déjà couvertes par une FAQ sont les meilleurs candidats : gros volume, faible marge d’appréciation.
- La disponibilité réelle des données et des actions. Vérifiez que l’accès à l’API de gestion des commandes, au RMM ou au CRM est techniquement possible avant de promettre une automatisation. Sans accès, il n’y a pas d’action, juste une réponse théorique.
- Le rapport impact/risque. Estimez le gain de temps par ticket, la réduction attendue sur les délais de traitement (SLA) et le coût par résolution automatisée, puis mettez-le en regard du risque : données sensibles manipulées, probabilité de récontact si la réponse est incomplète.
Les catégories qui cumulent fort volume, données accessibles et faible risque sont celles à traiter dès la première vague. Le reste attend son tour.
Quelles intégrations rendent l’IA fiable et traçable ?
Un système d’auto-résolution n’est fiable que si ses réponses sont ancrées dans des sources vérifiables. C’est le rôle du RAG : indexer une base de connaissances validée par les équipes, pour que chaque réponse générée cite un document réel plutôt qu’une reconstruction du modèle. Sans cette base propre et à jour, l’automatisation tourne en boucles inefficaces, un facteur de succès numéro un trop souvent sous-estimé dans les déploiements précipités.
Les connecteurs prioritaires à mettre en place sont les suivants.
- Le logiciel de ticketing (Zendesk ou équivalent), pour la lecture et l’écriture des tickets.
- Le CRM, pour contextualiser l’historique client.
- Le RMM, pour les actions techniques exécutables à distance côté IT.
- La base de connaissances elle-même, indexée et régulièrement nettoyée.
- Les journaux d’audit, pour tracer chaque décision automatisée.
Un cas concret illustre l’intérêt d’une intégration directe PSA/RMM : les agents intégrés à l’écran de ticket, connectés au RMM, permettent des corrections en un clic et réduisent nettement les temps de résolution sur les tickets L1, comme le montre le retour d’expérience de JieGou sur ConnectWise.
Le choix entre une API cloud et un modèle exécuté en local dépend de la sensibilité des données traitées, un point détaillé dans la section suivante.
Conseil de pro : Ne connectez jamais un agent IA à une action d’écriture (remboursement, modification de compte) sans journal d’audit actif dès le premier jour. C’est le détail que les équipes ajoutent en urgence après un incident, alors qu’il coûte une heure à configurer en amont.
Comment déployer l’auto-résolution sans risquer le service client ?
Se précipiter vers l’autonomie complète est la première cause d’échec des projets d’auto-résolution. La méthode qui limite les mauvaises surprises suit trois étapes, jamais raccourcies.
- Simuler sur l’historique. Faites tourner le système sur plusieurs milliers de tickets déjà traités et comparez ses réponses proposées aux résolutions réelles. Cette étape est la plus rentable de tout le projet : elle révèle le taux de résolution réaliste avant toute mise en production et évite de calibrer les seuils de confiance à l’aveugle, comme le souligne l’analyse d’eesel AI sur l’automatisation des tickets.
- Passer en mode copilote. L’IA génère des brouillons envoyés aux agents humains, qui corrigent, valident ou rejettent. Chaque correction réinjectée nourrit l’amélioration continue du modèle, une boucle qui accélère nettement la montée en fiabilité par rapport à un entraînement isolé.
- Autonomiser progressivement, catégorie par catégorie. Une fois qu’une catégorie de tickets atteint un taux de résolution jugé fiable pendant la phase copilote, elle bascule en résolution automatique complète, avec un mécanisme de retour en arrière (rollback) immédiat en cas de dérive.
Cette progression n’est pas une précaution excessive : elle correspond à la trajectoire suivie par les déploiements qui tiennent la distance, plutôt que ceux qui promettent une autonomie totale dès le premier mois.
La gouvernance qui accompagne cette montée en puissance repose sur des seuils de confiance ajustables par catégorie, une politique d’escalade écrite et documentée, et des audits périodiques des décisions automatisées pour détecter toute dérive avant qu’elle n’affecte le client final.
Quels indicateurs prouvent que l’auto-résolution fonctionne vraiment ?
La mesure la plus importante, et la plus souvent biaisée dans les argumentaires commerciaux, distingue la résolution vraie de la simple déviation. Un ticket « dévié » signifie que le client n’a pas contacté un agent humain immédiatement, ce qui ne signifie pas que son problème est résolu. Certains fournisseurs annoncent des taux d’auto-résolution élevés, comme les 70 % revendiqués par PaperOffice, sans toujours préciser cette distinction, ce qui invite à lire ces chiffres avec prudence.
Les indicateurs à suivre en priorité sont les suivants.
- Le taux de résolution vraie : tickets clôturés sans aucune intervention humaine, vérifiés après une fenêtre d’inactivité définie.
- Le taux de récontact : le client revient-il sur le même sujet dans les jours suivants ?
- Le CSAT segmenté par intention, pour repérer les catégories où l’IA satisfait moins que la moyenne.
- Le temps moyen de traitement et le taux d’escalade vers un agent humain.
Zendesk précise d’ailleurs que ses résolutions automatisées ne sont comptabilisées qu’après une période d’inactivité de 72 heures, et seulement si la conversation est jugée close sans reprise humaine, une méthode de calcul qui mérite d’être reproduite en interne quel que soit l’outil utilisé.
Des tableaux de bord dédiés et des tests A/B entre configurations de seuils permettent d’objectiver ces résultats plutôt que de se fier à une impression générale de fluidité.
Comment sécuriser les données dans un système d’auto-résolution ?
Un agent IA qui accède aux tickets touche presque toujours des données personnelles : coordonnées, historique d’achat, parfois informations de paiement. Trois règles limitent l’exposition.
- Restreindre l’accès aux seules données nécessaires à la catégorie de ticket traitée, sans lecture élargie par défaut.
- Journaliser systématiquement les sources RAG citées dans chaque réponse automatisée, pour garder une traçabilité complète en cas de litige.
- Fixer des seuils de confiance stricts et des tests de validation continue, avec un mécanisme de rollback immédiat si le taux d’erreur dépasse un plafond défini.
Conseil de pro : Documentez par écrit, avant le lancement, ce qui se passe en cas de panne du fournisseur IA. Un plan de repli mal préparé transforme un incident technique mineur en interruption de service visible par les clients.
Comment gérer les tickets ambigus que l’IA ne peut pas résoudre seule ?
Tout système d’auto-résolution rencontre des tickets qui sortent du cadre prévu : formulation vague, mélange de plusieurs demandes, ton clairement mécontent, ou sujet jamais rencontré dans l’historique d’entraînement. La bonne pratique n’est pas de forcer une réponse, mais de reconnaître l’incertitude et d’agir en conséquence.
Trois mécanismes limitent les dégâts. D’abord, un seuil de confiance minimal en dessous duquel le système bascule automatiquement vers l’escalade, plutôt que de proposer une réponse approximative. Ensuite, un résumé structuré du contexte déjà traité (échanges précédents, intention détectée, actions déjà tentées) transmis à l’agent humain, pour qu’il ne reparte pas de zéro. Enfin, une catégorie explicite de « tickets multi-intentions » : lorsqu’un message combine par exemple une demande de remboursement et une plainte sur un délai de livraison, le système doit détecter la complexité plutôt que de traiter uniquement la première intention identifiée.
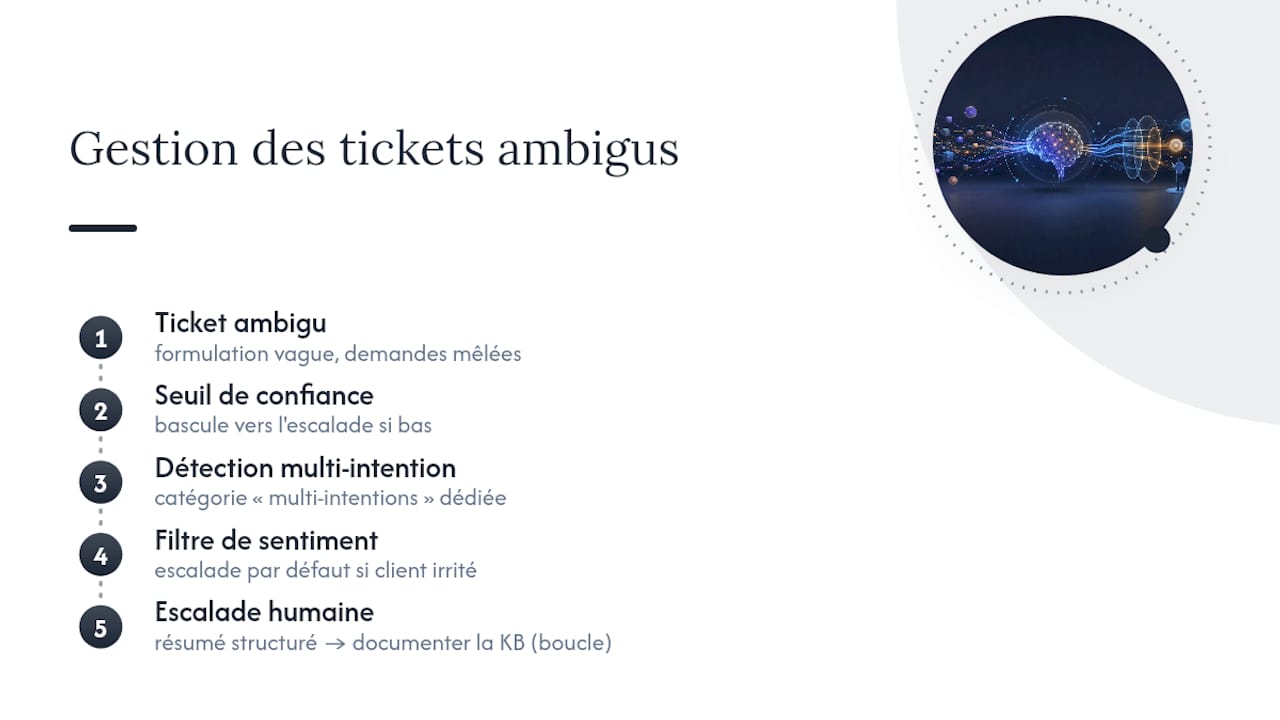
Le sentiment du client compte autant que le contenu de la demande. Un ticket rédigé sur un ton clairement irrité, même simple sur le fond, gagne à être escaladé par défaut : la valeur d’un agent humain dans ce cas dépasse largement le gain de temps d’une réponse automatisée. Les équipes qui réussissent leur déploiement configurent ce filtre de sentiment dès la phase copilote, pas après les premières plaintes.
Enfin, chaque escalade doit nourrir la base de connaissances : un ticket ambigu résolu manuellement aujourd’hui devient, une fois documenté, un cas que l’IA pourra traiter seule demain.
L’auto-résolution IA respecte-t-elle la vie privée des clients ?
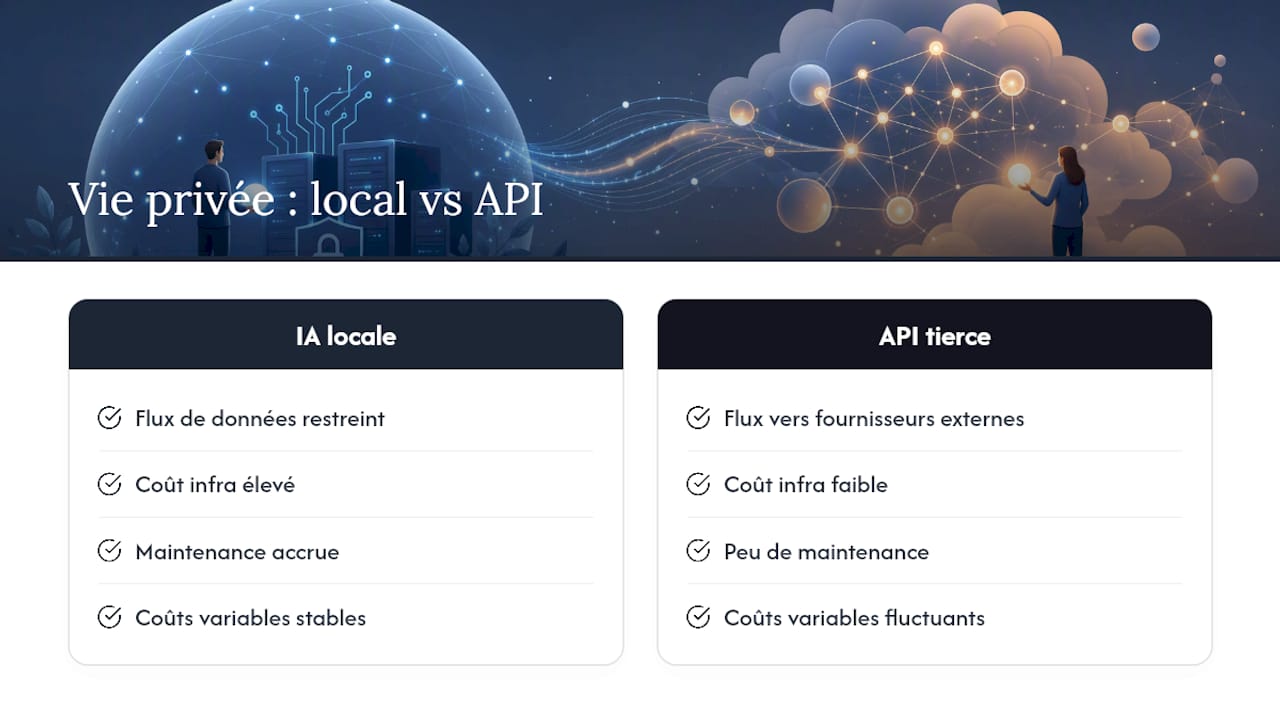
La question dépasse la conformité réglementaire de surface. La direction interarmées du renseignement recommande, pour les entreprises traitant des données hautement sensibles, de privilégier des modèles IA locaux plutôt que des API tierces, afin de réduire les flux de données vers des fournisseurs externes et de faciliter la conformité contractuelle avec les sous-traitants.
Ce choix a un coût opérationnel réel : un modèle local demande davantage de ressources d’infrastructure et de maintenance qu’un simple appel API, mais il évite l’envoi systématique de données client vers des serveurs tiers et stabilise les coûts variables liés à l’usage.
Trois pratiques concrètes réduisent l’exposition sans renoncer à l’automatisation. Anonymiser ou pseudonymiser les champs sensibles avant tout envoi vers un modèle externe, quand la nature du ticket le permet techniquement. Définir contractuellement une durée de conservation limitée des échanges traités par l’IA, plutôt qu’un stockage indéfini par défaut. Documenter précisément, pour chaque connecteur (CRM, RMM, ticketing), quelles données transitent et vers quel service, un exercice souvent négligé une fois le système en production.
La confiance des clients dans un canal de support automatisé se construit aussi sur la transparence : signaler clairement quand une réponse provient d’un système automatisé plutôt que de la faire passer pour humaine reste, sur ce point précis, une question de cohérence autant que de réglementation.
Dans quels secteurs l’auto-résolution ia fait-elle déjà ses preuves ?
Le e-commerce reste le terrain le plus mûr : suivi de commande, gestion des retours, questions sur les délais de livraison forment un socle de tickets à haut volume et faible marge d’appréciation, parfaitement adapté à une résolution automatisée dès les premières semaines de déploiement.
Le secteur IT et les prestataires de services managés exploitent une autre force de l’auto-résolution : l’exécution d’actions techniques. Un agent connecté au RMM peut relancer un service, réinitialiser un accès ou exécuter un script correctif sans attendre l’intervention d’un technicien, ce qui réduit sensiblement les délais sur les tickets L1 les plus répétitifs, comme le montre l’expérience rapportée par JieGou sur les intégrations ConnectWise.
Les éditeurs de logiciels et plateformes SaaS traitent un volume massif de questions de configuration et d’erreurs documentées, souvent déjà présentes dans leur centre d’aide : le RAG y trouve un terrain particulièrement favorable puisque la matière première existe déjà.
Le secteur bancaire et l’assurance avancent plus lentement, freinés par la sensibilité des données et les exigences de traçabilité, mais y trouvent des cas d’usage solides sur des tickets à faible enjeu : consultation de solde, statut de dossier, questions sur les délais de traitement. Les demandes touchant à un litige financier ou à une réclamation restent, elles, quasi systématiquement escaladées vers un humain.
Quel impact l’automatisation a-t-elle sur les équipes support ?
La crainte la plus répandue chez les équipes support n’est pas irrationnelle : automatiser les tickets simples, c’est aussi retirer une partie du travail le plus répétitif, mais parfois le plus rassurant, de leur quotidien. La réponse honnête n’est pas de nier ce changement, mais de le nommer clairement dès le lancement du projet.
Dans les déploiements qui fonctionnent, le rôle des agents humains se déplace plutôt qu’il ne disparaît : moins de tickets à faible valeur, davantage de dossiers complexes et de relations clients à fort enjeu émotionnel. Cette bascule demande un accompagnement réel, pas seulement une annonce. Les agents qui passent en phase copilote, où ils valident ou corrigent les brouillons générés par l’IA, restent en position de contrôle sur la qualité du service, ce qui change profondément la perception du projet en interne par rapport à un déploiement imposé sans transition.
Le risque éthique le plus sérieux concerne la transparence envers le client final : faire croire qu’un échange est humain quand il ne l’est pas érode la confiance dès que le client s’en rend compte, souvent au moment où sa demande dépasse le cadre prévu par le système. Signaler clairement la nature automatisée d’une réponse, tout en garantissant un accès rapide à un humain en cas de besoin, reste la position la plus défendable sur le long terme.
Où l’IA échoue-t-elle encore sur les tickets complexes ?
L’auto-résolution ne traite pas correctement les demandes qui exigent un jugement contextuel fin : un client fidèle depuis dix ans qui demande une exception commerciale, une situation qui mêle un problème technique et une insatisfaction plus profonde, ou un cas juridique limite. Le modèle peut produire une réponse plausible sans en mesurer les conséquences réelles pour l’entreprise.
Le deuxième point faible tient à la fraîcheur de la base de connaissances. Un système RAG répond aussi bien que sa documentation source : si une procédure a changé la semaine dernière mais que le centre d’aide n’a pas été mis à jour, l’IA citera une source obsolète avec la même assurance qu’une information exacte. Le risque de fabrication n’est pas éliminé, seulement réduit, par l’ancrage RAG.
Les tickets multilingues ou fortement chargés d’expressions idiomatiques locales restent également source d’erreurs de classification, en particulier sur la détection fine du sentiment. Enfin, aucun système actuel ne gère bien l’ambiguïté volontaire, ces messages où le client teste délibérément les limites du système pour obtenir un geste commercial, un cas de figure que seul un agent expérimenté sait généralement désamorcer.
Perspective BotiqueAI
Ce que beaucoup d’entreprises sous-estiment, c’est que l’écart entre un projet d’auto-résolution qui échoue et un projet qui tient dans la durée se joue rarement sur le choix du modèle d’IA. Il se joue sur la discipline de la phase de simulation, celle que tout le monde a envie d’écourter pour aller plus vite en production. Chez Botiqueai, l’expérience accumulée sur des intégrations d’agents IA dans les parcours clients confirme systématiquement ce constat : un PoC construit sur l’historique réel du client, pas sur des cas fictifs, révèle des angles morts qu’aucune démonstration commerciale ne montre.
— Botiqueai
Comment Botiqueai vous accompagne dans votre projet d’auto-résolution
Passer de la théorie à un système qui tourne réellement en production demande un audit précis avant toute chose : quelles catégories de tickets, quelles données disponibles, quels connecteurs déjà en place. Il est possible de réaliser un audit et un test de type PoC directement sur vos tickets historiques, sans engagement, pour mesurer un taux de résolution réaliste avant toute décision d’investissement.
L’accompagnement couvre l’intégration technique complète, ancrage RAG sur votre base de connaissances, connexion à votre outil de ticketing et à votre CRM ou RMM, jusqu’à l’exploitation continue via un abonnement adapté à votre volume. Pour les projets e-commerce, les formules Starter à 19 $ par mois et Pro à 49 $ par mois couvrent le développement d’applications Shopify liées à l’automatisation du support. Pour des besoins plus spécifiques, les automatisations sur mesure et le produit Aria by BotiqueAI s’adaptent à des architectures métier plus complexes, incluant l’exécution d’actions via n8n et Make.
La première étape reste simple : demander l’audit gratuit et lancer une simulation sur vos propres tickets, directement sur le site de Botiqueai, pour voir ce que votre volume réel donnerait avant tout engagement.
Sources
Pour aller plus loin techniquement, la documentation Zendesk sur l’assistance automatique détaille le fonctionnement des actions pré-approuvées. Sur la gestion des risques liés aux données, les recommandations de la DGSI posent un cadre utile pour tout projet manipulant des données sensibles.
- Utilisation de l’assistance automatique pour résoudre les tickets — Zendesk Support
- Automatisation des tickets de support : comment ça fonctionne vraiment en 2026 — eesel AI
- Risques associés à l’usage de l’intelligence artificielle dans le monde professionnel — DGSI
Questions fréquentes
Quels tickets automatiser en premier avec l’auto-résolution IA ?
Commencez par les tickets à fort volume et faible marge d’appréciation : suivi de commande, réinitialisation de mot de passe, questions déjà couvertes par votre FAQ. Ces catégories combinent le meilleur rapport entre gain de temps et risque limité.
Quelle différence entre déviation et résolution réelle ?
La déviation signifie simplement que le client n’a pas contacté un agent humain, sans garantir que son problème est résolu. La résolution réelle se mesure après une fenêtre d’inactivité définie, une fois vérifié qu’aucune reprise humaine n’a été nécessaire.
Comment sécuriser les données sensibles dans un système d’auto-résolution ?
Limitez l’accès aux données strictement nécessaires par catégorie de ticket et journalisez chaque source citée par l’IA. Pour les données très sensibles, privilégier un modèle local plutôt qu’une API tierce reste la recommandation la plus prudente.
Combien coûte un projet d’auto-résolution avec Botiqueai ?
Les services de développement de chatbots IA et d’intégration sont proposés sur devis après un audit gratuit. Pour les projets Shopify liés au support automatisé, les tarifs publics démarrent avec la formule Starter à 19 $ par mois.
Faut-il toujours passer par une phase copilote avant l’autonomie complète ?
Oui, dans la quasi-totalité des déploiements réussis. La phase copilote permet aux agents de corriger les brouillons générés par l’IA, ce qui calibre les seuils de confiance avant d’activer la résolution automatique sur une catégorie donnée.