Recherche sémantique en entreprise : guide décideurs 2026
Recherche sémantique en entreprise : guide décideurs 2026
La recherche sémantique permet de retrouver l’information métier pertinente même quand un collaborateur ne tape pas les bons mots-clés, ce qui réduit les recherches infructueuses et accélère la prospection B2B. Elle repose sur des embeddings et une architecture hybride combinant vecteurs et mots-clés, une approche que documente notamment IBM. Des cabinets spécialisés déploient déjà ce type de solution pour des clients de renom.
En bref:
- La recherche sémantique réduit le taux de résultats nuls en comprenant l’intention derrière une requête plutôt que de rechercher une correspondance exacte des mots-clés.
- La mise en œuvre nécessite un pipeline technique complet : collecte, nettoyage, vectorisation, stockage vectoriel, et re-rankage pour garantir une pertinence optimale.
- Elle améliore significativement la productivité en prospection B2B, notamment pour qualifier rapidement les prospects et personnaliser les messages en croisant des données internes et externes.
- La solution hybride combinant recherche vectorielle et mots-clés précis est recommandée pour garantir la précision des références, numéros ou acronymes critiques.
- La gouvernance des données, incluant la traçabilité et le respect des droits d’accès, est essentielle pour assurer la fiabilité et la conformité de la recherche sémantique.
Table des matières
- Qu’est-ce que la recherche sémantique en entreprise ?
- Comment fonctionne la recherche sémantique en pratique ?
- Quels bénéfices concrets pour la productivité et la prospection B2B ?
- Quelle architecture et quels composants choisir ?
- Quels pré-requis avant de lancer un projet pilote ?
- Quels cas d’usage métiers concrets pour la recherche sémantique ?
- Comment mesurer la qualité d’une solution sémantique ?
- Gouvernance des données : quelles bonnes pratiques adopter ?
- Des preuves concrètes : ce que montrent les projets déjà déployés
- Priorités pour un CIO ou un directeur innovation
- Sources
- Questions fréquentes
Qu’est-ce que la recherche sémantique en entreprise ?
Une recherche sémantique comprend le sens d’une requête plutôt que de comparer des chaînes de caractères. Quand un commercial tape « client qui a annulé un contrat l’an dernier », un moteur par mots-clés classique cherche ces termes exacts dans les documents. Un moteur sémantique, lui, comprend l’intention et retrouve les fiches pertinentes même si elles parlent de « résiliation » ou de « fin d’abonnement ».
Cette capacité repose sur les embeddings : des représentations mathématiques qui transforment un mot, une phrase ou un document entier en vecteur de nombres. Deux textes au sens proche produisent des vecteurs proches dans cet espace, ce qui permet de mesurer une similarité de sens plutôt qu’une simple correspondance de texte, comme l’explique idataweb. La recherche devient alors un calcul de distance entre vecteurs, exécuté dans une base de données vectorielle.
Deux briques complètent ce socle technique :
- Le re-ranking : une seconde passe qui réordonne les résultats initiaux selon des critères métier (fraîcheur du document, autorité de la source, historique d’usage).
- Le RAG (génération augmentée par récupération) : le moteur sémantique alimente un modèle de langage avec les documents les plus pertinents avant qu’il ne formule une réponse, ce qui ancre la génération dans des faits vérifiables plutôt que dans la seule mémoire du modèle.
- La couche hybride : elle combine recherche vectorielle et correspondance par mots-clés pour ne jamais perdre un acronyme, une référence produit ou un numéro de contrat que les vecteurs seuls pourraient diluer.
L’approche hybride n’est pas un compromis technique mineur. IBM la présente comme la norme recommandée en entreprise, car elle marie la compréhension du sens avec la précision sur les termes exacts, un équilibre qu’aucune des deux méthodes prises isolément n’atteint seule. Les fondements théoriques de cette évolution, de la correspondance lexicale vers des méthodes fondées sur le sens, sont documentés depuis longtemps dans les travaux de référence sur la récupération d’information. Pour approfondir le lien entre traitement du langage et pertinence des résultats, notre guide sur le NLP en entreprise détaille les mécanismes sous-jacents.
Comment fonctionne la recherche sémantique en pratique ?
Avant qu’un utilisateur tape sa première requête, un pipeline entier doit tourner en arrière-plan. Voici les étapes concrètes qu’une équipe technique doit orchestrer.
- Collecte des sources. On rassemble les documents internes : wiki, CRM, base produit, tickets de support, contrats. Chaque source a son propre format et sa propre fraîcheur, ce qui impose un nettoyage préalable (suppression des doublons, normalisation des métadonnées).
- Découpage et vectorisation. Les documents longs sont fragmentés en passages cohérents, puis chaque fragment passe par un modèle d’embeddings qui génère son vecteur.
- Stockage dans une base vectorielle. Ces vecteurs sont indexés dans une base spécialisée, capable de retrouver rapidement les voisins les plus proches parmi des millions d’entrées.
- Requêtage et re-ranking. À chaque question posée, le système vectorise la requête, cherche les passages les plus proches, puis un re-ranker affine l’ordre final avant affichage.
- Mise en cache et supervision. Les requêtes fréquentes sont mises en cache pour réduire la latence, et un tableau de bord surveille les temps de réponse.
Un point souvent sous-estimé : la fréquence de réindexation. Un catalogue produit qui change chaque semaine exige une réindexation incrémentale régulière, sinon le moteur répond avec des informations obsolètes. C’est un sujet à trancher dès la phase de cadrage, pas après la mise en production.
Conseil de pro : ne cherchez pas à remplacer votre moteur de recherche existant du premier coup. Des systèmes comme Elasticsearch ou Solr peuvent recevoir une couche vectorielle en complément, ce qui améliore la pertinence sans réécrire toute l’infrastructure, une approche que confirme idataweb.
Un re-ranker entraîné sur des données propres à l’entreprise permet aussi de corriger les priorités métier, par exemple en privilégiant systématiquement les documents validés par la conformité plutôt qu’une version brouillon oubliée dans un dossier partagé.
Quels bénéfices concrets pour la productivité et la prospection B2B ?
Le gain le plus visible touche le taux de résultats nuls, c’est-à-dire la proportion de recherches internes qui ne renvoient rien d’exploitable. Une recherche par mots-clés classique échoue dès que l’utilisateur emploie un synonyme, une abréviation métier ou une formulation approximative. La recherche sémantique comprend l’intention derrière la requête et réduit mécaniquement ce taux d’échec, un effet largement documenté dans la littérature sur les embeddings et la similarité sémantique.
Pour la prospection B2B, l’impact se joue à trois niveaux, notamment lorsqu’on utilise des contenus multiformats comme la vidéo, essentiels en audiovisuel d’entreprise :
- Qualification plus rapide des prospects : un commercial retrouve en quelques secondes l’historique complet d’un compte, même dispersé entre CRM, e-mails et comptes-rendus.
- Personnalisation des messages : croiser les besoins exprimés par un prospect avec des études de cas similaires devient un calcul de similarité vectorielle plutôt qu’une recherche manuelle fastidieuse.
- Taux de conversion en hausse : moins de temps perdu à chercher l’argument juste, plus de temps passé à échanger avec le client.
Point clé : au-delà de la productivité pure, mesurer la part de contenus effectivement cités ou retenus par les outils d’IA internes doit désormais faire partie du tableau de bord de pilotage, selon les recommandations de la méthodologie SEO sémantique 2026.
L’effet transverse mérite aussi l’attention du comité de direction. Un onboarding de nouvel employé s’accélère quand la documentation interne répond directement aux questions posées en langage naturel, sans obliger le nouvel arrivant à connaître le vocabulaire exact de l’entreprise. Le support client bénéficie du même effet : moins d’escalades vers un expert humain, car l’assistant retrouve la bonne réponse même formulée différemment d’une fiche existante. La satisfaction interne, mesurée par un NPS dédié aux outils de recherche, progresse souvent en parallèle de ces gains de temps.
Quelle architecture et quels composants choisir ?
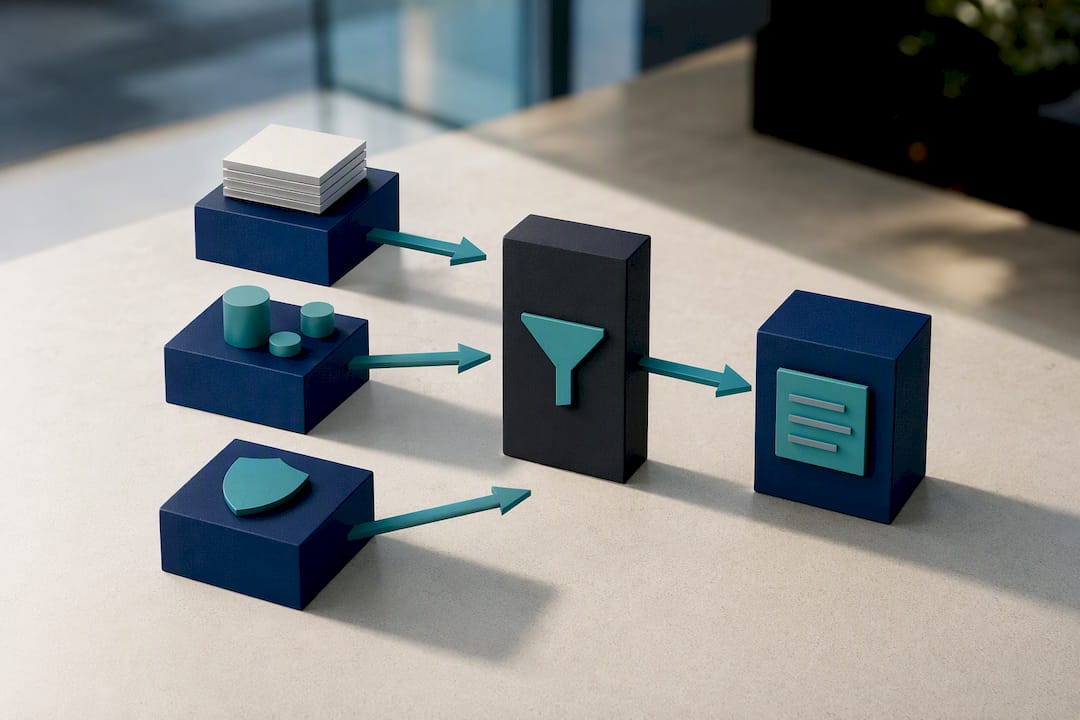
Le choix d’architecture conditionne la scalabilité, la latence et la conformité du projet sur plusieurs années. Un comité technique doit trancher sur quatre briques principales avant tout développement.
- Le moteur d’ingestion : il connecte les sources hétérogènes (CRM, ERP, wiki, stockage documentaire) et normalise les formats avant vectorisation.
- La base de données vectorielle : elle stocke les embeddings et exécute les recherches de similarité à grande échelle. Le choix dépend du volume de documents et de la fréquence de mise à jour attendue.
- Le re-ranker : une couche additionnelle qui affine l’ordre des résultats selon des règles métier, souvent entraînée sur des données propres à l’organisation.
- La couche hybride mots-clés : indispensable pour ne pas perdre la précision sur les références exactes, numéros de série ou codes internes.
Sur l’hébergement, trois options coexistent. Le cloud public offre la scalabilité la plus rapide à mettre en œuvre, mais impose de vérifier où sont physiquement stockées les données, un point sensible pour toute entreprise soumise au RGPD. L’hébergement sur site (on-premise) garantit un contrôle total sur la souveraineté des données, au prix d’une charge opérationnelle plus lourde. Un modèle mixte, courant chez les grandes entreprises, héberge les données sensibles en interne et externalise les charges de calcul les moins critiques.
Les approches industrielles les plus récentes recommandent d’ailleurs une récupération agentique en plusieurs étapes, où le système interroge successivement plusieurs sources avant de synthétiser une réponse, plutôt qu’une requête unique et brute. Cette logique, décrite par IBM watsonx, renforce à la fois la précision et la gouvernance des réponses produites, un point que tout responsable sécurité appréciera lors de l’audit du projet.
Quels pré-requis avant de lancer un projet pilote ?
Avant de commander le moindre développement, un audit honnête des sources existantes évite bien des déconvenues. Trois questions structurent ce diagnostic initial : combien de documents doivent être indexés, quelle est leur qualité actuelle, et quel est le taux de résultats nuls mesuré aujourd’hui sur les outils existants. Ce chiffre de départ servira de référence pour évaluer les progrès une fois le projet lancé.
- Cadrer le périmètre. Choisir un cas d’usage limité mais à fort impact, par exemple une base de connaissances support, plutôt que de viser l’ensemble du patrimoine documentaire d’un coup. IBM recommande explicitement cette logique de pilote circonscrit pour démontrer la valeur rapidement.
- Constituer l’équipe. Un projet sérieux mobilise un product owner métier, un data engineer pour le pipeline d’ingestion, un spécialiste NLP pour le paramétrage des embeddings, et un référent sécurité pour valider les accès et la conformité.
- Construire la roadmap. Un prototype technique en quelques semaines, suivi d’un pilote mesurable sur un périmètre restreint pendant deux à trois mois, puis une industrialisation progressive vers d’autres cas d’usage.
Pour la partie prospection B2B en particulier, croiser les données internes avec des sources officielles fiables améliore nettement la qualité de l’enrichissement CRM. Le registre national des entreprises constitue une référence solide pour valider et nettoyer les fiches prospects avant de les intégrer au moteur sémantique.
Quels cas d’usage métiers concrets pour la recherche sémantique ?
Trois familles d’usage reviennent systématiquement dans les projets d’entreprise, et chacune se mesure différemment.
- Assistant de support interne : un agent conversationnel branché sur la base de connaissances réduit le temps moyen de résolution d’un ticket, car il retrouve la procédure exacte même quand l’agent formule sa question autrement que dans la documentation d’origine. Notre article sur les chatbots SaaS détaille ce type de déploiement.
- Recherche produit enrichie : un catalogue volumineux devient consultable en langage naturel, ce qui accélère la réponse à un client qui décrit un besoin sans connaître la référence exacte du produit.
- Enrichissement CRM pour la prospection : croiser automatiquement les signaux d’un prospect (secteur, taille, historique d’échanges) avec des cas similaires déjà traités par l’entreprise, pour proposer au commercial l’argumentaire le plus pertinent.
Le retour sur investissement se mesure différemment selon le cas d’usage : temps de résolution pour le support, taux de conversion pour la prospection, ou volume de requêtes traitées sans intervention humaine pour la recherche produit. Fixer ces indicateurs avant le lancement du pilote évite les débats interminables une fois les résultats obtenus.
Comment mesurer la qualité d’une solution sémantique ?
Quatre indicateurs suffisent pour piloter sérieusement un projet, à condition de les suivre régulièrement plutôt que ponctuellement.
| Indicateur | Ce qu’il mesure | Fréquence de suivi recommandée |
|---|---|---|
| Taux de résultats nuls | Part des recherches sans réponse exploitable | Hebdomadaire |
| Temps de recherche moyen | Durée entre la requête et l’action de l’utilisateur | Hebdomadaire |
| Taux de clic sur les réponses | Pertinence perçue des premiers résultats | Mensuelle |
| NPS interne sur l’outil | Satisfaction des utilisateurs internes | Trimestrielle |
La méthode la plus fiable pour valider les progrès reste le test A/B entre l’ancien moteur et le nouveau, complété par des sessions d’observation directe avec quelques utilisateurs représentatifs. Ces chiffres, présentés trimestriellement au comité de direction, transforment un projet technique abstrait en preuve business tangible.
Gouvernance des données : quelles bonnes pratiques adopter ?
La gouvernance n’est pas une case à cocher après coup, elle conditionne la fiabilité même des réponses produites. Trois principes structurent une mise en œuvre durable :
- Traçabilité complète : chaque réponse générée doit pouvoir remonter au document source, pour permettre une vérification humaine en cas de doute.
- Droits d’accès respectés : le moteur sémantique ne doit jamais exposer à un utilisateur un document auquel il n’aurait pas accès dans le système d’origine.
- Revue régulière du corpus : des documents obsolètes ou contradictoires faussent les résultats si personne ne les purge périodiquement.
Un risque technique moins connu mérite une vigilance particulière : l’overfitting sur un petit corpus. Un re-ranker entraîné sur seulement quelques centaines de documents internes peut apprendre des biais très spécifiques à cette base et mal généraliser dès qu’on élargit le périmètre. Des travaux de recherche récents soulignent d’ailleurs les limites des grands modèles de langage face à des sources hétérogènes et recommandent de croiser plusieurs méthodes plutôt que de se fier à une seule, comme le détaille cette prépublication de 2024.
Conseil de pro : fixez une règle simple avant tout déploiement : aucune donnée personnelle identifiable ne doit être vectorisée sans base légale claire au sens du RGPD. C’est plus facile à vérifier en amont qu’à corriger après l’indexation de millions de documents.
Des preuves concrètes : ce que montrent les projets déjà déployés
Botiqueai a accompagné des organisations comme Acolad et Pernod Ricard sur des projets d’intelligence artificielle intégrant des logiques de recherche et de traitement documentaire avancées. L’étude de cas Pernod Ricard illustre comment une solution IA sur mesure s’intègre dans des processus métiers réels plutôt que dans un environnement de test isolé.
Ces déploiements confirment une leçon transférable à toute entreprise : la valeur ne vient pas de la technologie seule, mais de son ancrage dans un cas d’usage précis, avec des métriques définies dès le départ. Contacter un intégrateur devient pertinent dès que le périmètre d’un pilote est clair et que les sources de données existantes ont été auditées, pas avant.
Priorités pour un CIO ou un directeur innovation
À trois mois, l’objectif est un pilote fonctionnel sur un périmètre restreint avec des métriques de départ documentées. À douze mois, l’objectif devient l’industrialisation vers deux ou trois cas d’usage supplémentaires, jamais tous en même temps. Le signal pour arrêter un pilote est clair : un taux de résultats nuls qui ne bouge pas après deux mois d’optimisation signale un problème de données, pas de modèle. Côté budget, mieux vaut sous investir sur un périmètre large que sur investir sur un périmètre flou.
— Botiqueai
Sources
Pour aller plus loin, l’ouvrage de référence Introduction to Information Retrieval de Stanford pose les bases théoriques. La documentation IBM watsonx détaille l’architecture hybride en contexte entreprise, et le guide AISO Hub sur le SEO sémantique couvre la cartographie d’entités.
Pour un accompagnement concret sur un projet de recherche sémantique, les solutions Botiqueai couvrent l’audit, le développement et l’intégration de ce type de dispositif dans vos outils métiers existants.
- Recherche d’entreprise basée sur l’IA - IBM watsonx.data
- Introduction to Information Retrieval — Stanford (IR book)
- arXiv preprint (2024-06)
Questions fréquentes
C’est quoi la recherche sémantique ?
C’est une méthode de recherche qui comprend le sens d’une requête plutôt que de comparer des mots exacts, grâce à des embeddings qui transforment textes et requêtes en vecteurs comparables par similarité.
Quelle IA pour trouver un nom d’entreprise ?
Aucun outil grand public n’est spécifiquement dédié à cette tâche ; en revanche, croiser une recherche sémantique avec des registres officiels comme le registre national des entreprises permet de vérifier et désambiguïser un nom d’entreprise fiablement.
C’est quoi un chercheur en sémantique ?
C’est un spécialiste qui étudie le sens des mots et des phrases, souvent en linguistique computationnelle ; en entreprise, ce rôle se traduit par des data scientists ou ingénieurs NLP chargés de concevoir et calibrer les modèles d’embeddings.
Comment faire des recherches sur une entreprise ?
Le plus fiable consiste à croiser une source officielle comme le registre entreprises avec vos données internes (CRM, historique d’échanges) via un moteur sémantique capable de relier automatiquement ces informations dispersées.